AI採用は履歴書の隠し文字も読む?約1%の研究と、人に戻す確認手順
PDFを開くと、整った職歴と資格の欄。ところがAIの要約には、画面に見当たらない経験が書かれている——。採用AIへ履歴書を渡すときは、書類の見た目と、機械が取り出す文字が同じとは限らない点に注意が必要です。
最初に整えたいのは「怪しい応募者を落とす仕組み」ではなく、原本・表示・抽出内容を照合し、差があれば人が再確認できる流れです。研究で報告された「約1%」も、日本の応募書類にそのまま当てはめられる数字ではありません。
この記事では、AIで応募書類を整理・一次評価する担当者に向けて、隠し文字の研究から分かることと、運用上の確認項目を分けます。特定の採用製品を試した実測ではありません。掲載予定のイラストは仕組みの説明用で、実在する応募者の書類や公式画面ではありません。情報確認日:2026年10月15日。
履歴書の「見える内容」とAIが読む内容はずれる
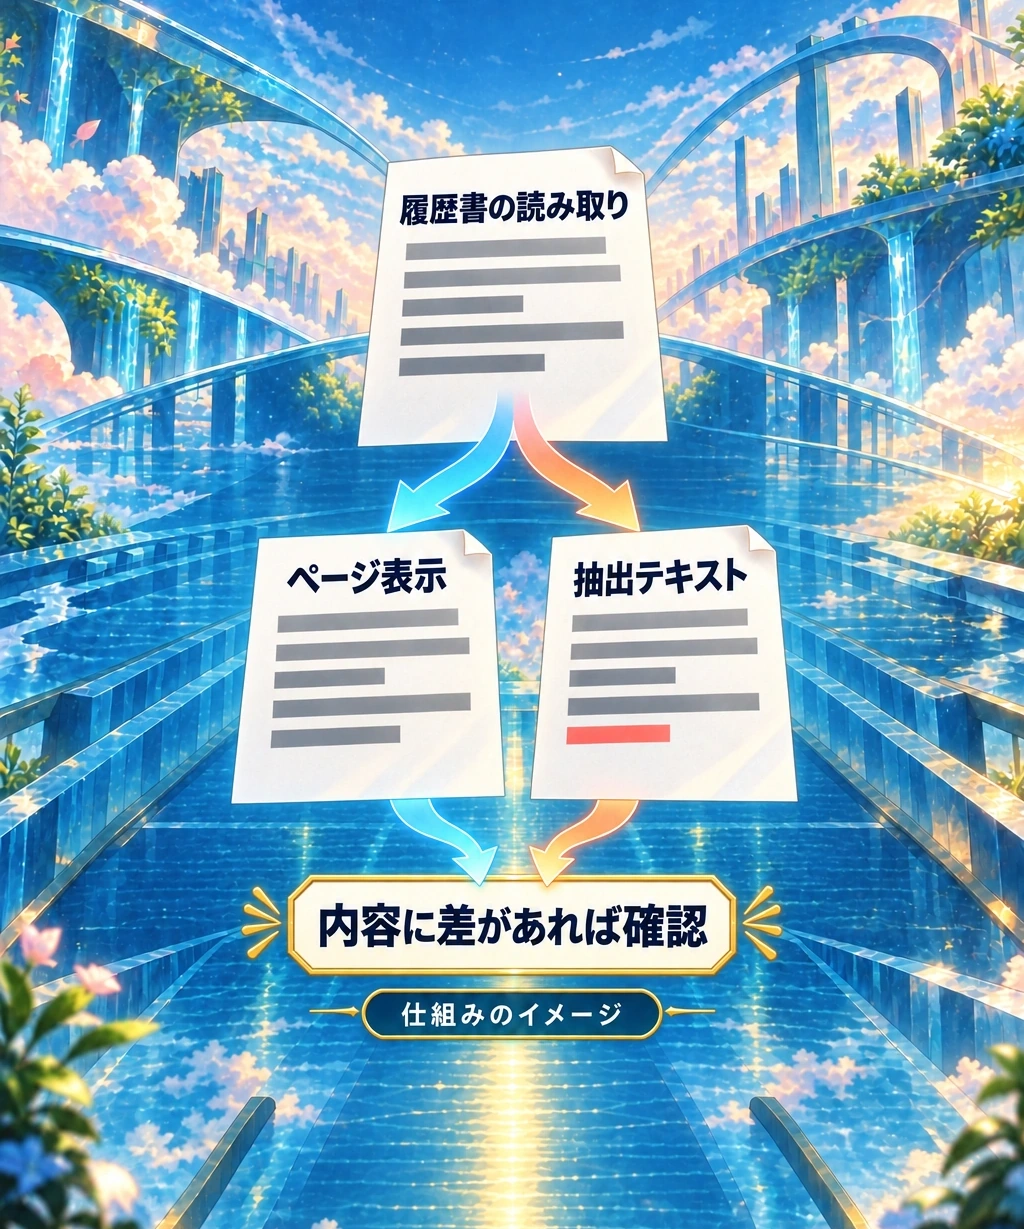
人はPDFのページを見ます。一方、採用ツールはPDF内のテキストを抽出してからAIへ渡すことがあります。この二つの経路に差があると、画面で確認できない文字が、AIの評価材料へ混ざり得ます。
2026年の履歴書研究は、人に見えにくい内容を、表示と抽出結果の両面から調べました。問題は「以前の指示を無視して」といった命令文だけではありません。検出内容の大半は、スキルや経歴など、採用に関係する隠れた情報でした。したがって、特定の命令語を探すだけでは確認が足りません。研究本文の検出方法・分類で条件を確認できます。
たとえば、表示にはない資格名が抽出結果に現れたら、それをAIが根拠として採用していないかを確かめます。これは説明用の場面であり、実際の応募者の不正を示す例ではありません。逆に、抽出順の乱れや文書変換の残骸を、隠し操作と早合点するのも避けたいところです。
画面と抽出結果が違うことは、確認を始める理由です。それだけで意図や経歴の真偽が確定するわけではありません。では、話題の「約1%」は、何をどこまで示しているのでしょうか。
約1%は何を数えた数字?採用結果とは分けて読む
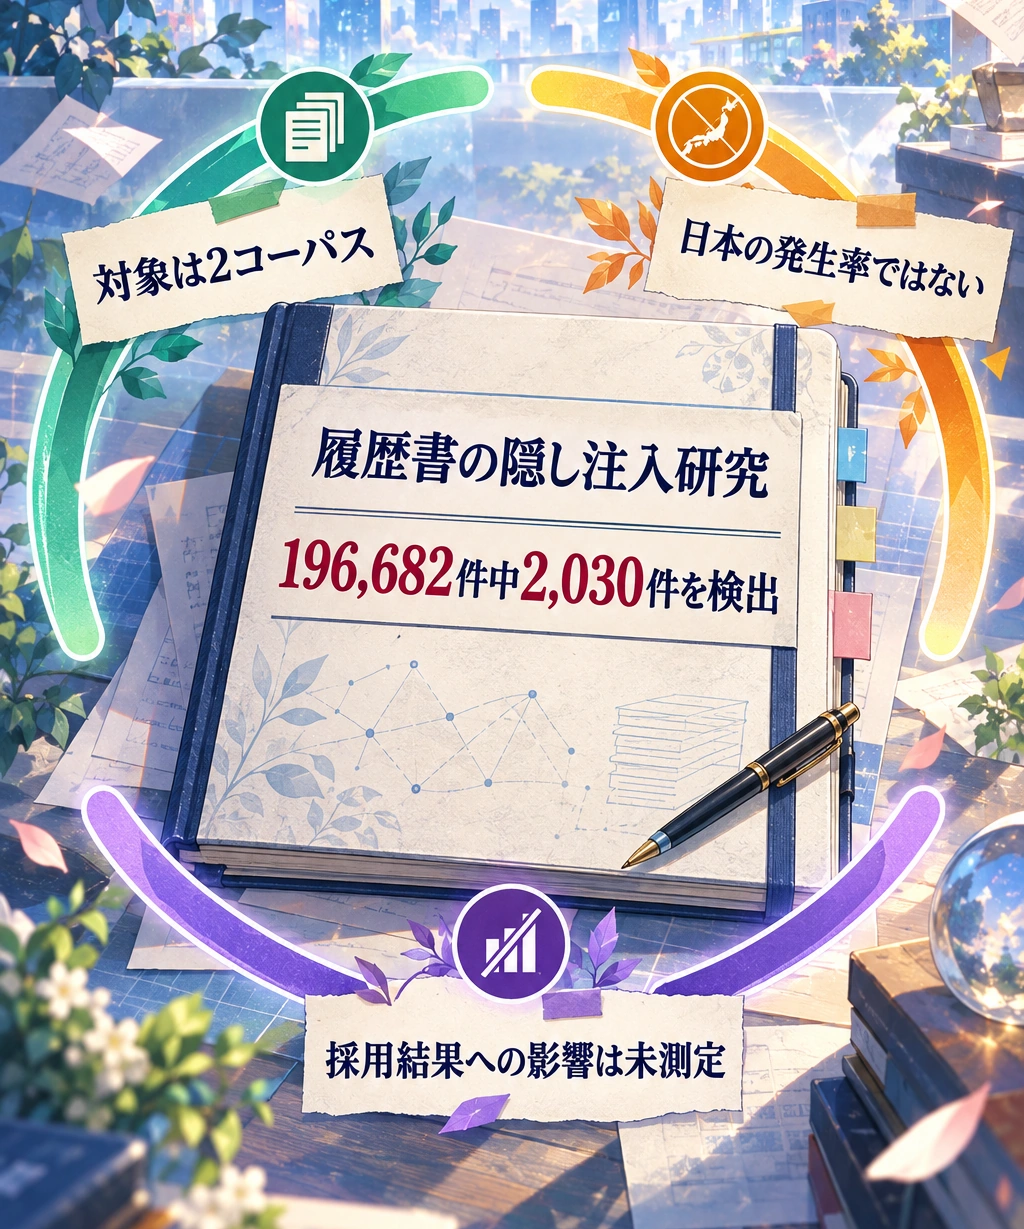
USENIX Security 2026で発表された研究は、hireEZ由来の二つの履歴書データ群、計196,682件を分析しました。HCDという検出方法が隠し注入として拾ったのは2,030件です。内訳は次のとおりです。
| 研究対象 | 分析した履歴書 | HCDによる検出 |
|---|---|---|
| 応募者マッチング由来 | 83,277件 | 993件/1.19% |
| ATS由来 | 113,405件 | 1,037件/0.91% |
出典:研究本文4・5.2・6.1・7節、USENIX発表ページ。二つは同じプラットフォーム由来で、対象期間も異なります。日本全国の応募者を代表する調査ではありません。
さらに、手作業の確認から推定したHCDの適合率は86.1%。これは「検出したもののうち正しく検出できた割合」の推定であり、採用AIの評価が86.1%正しいという意味ではありません。すべての見逃しを調べたわけでもなく、厳密な再現率は不明です。著者は見逃しの可能性から下限推定と位置付けますが、誤検出もあるため、自社の発生率へ機械的に換算できません。
もう一つの線引きは、隠し内容の検出件数と、合否が変わった件数は別ということ。この大規模研究は実際の選考結果への影響を評価していません。「100通処理すれば必ず1通」「2,030人が選考を突破した」とは読めない数字です。
自社で必要なのは、研究の比率を目標値にすることではなく、どの入力を確認し、何を評価の根拠として残すかを決めることです。その入口として、まず同じ書類の三つの状態をそろえます。
まず原本・表示・抽出の3点をそろえる
受領原本を保全する
版や受付日時を対応付け、比較用のコピーと分けて扱う。
表示と実際の入力を並べる
利用ツールがAIへ渡す内容を確認し、読取失敗や差分を記録する。
差分を担当者へ戻す
該当ページと抜粋を残し、評価へ混ぜる前に人が確認する。
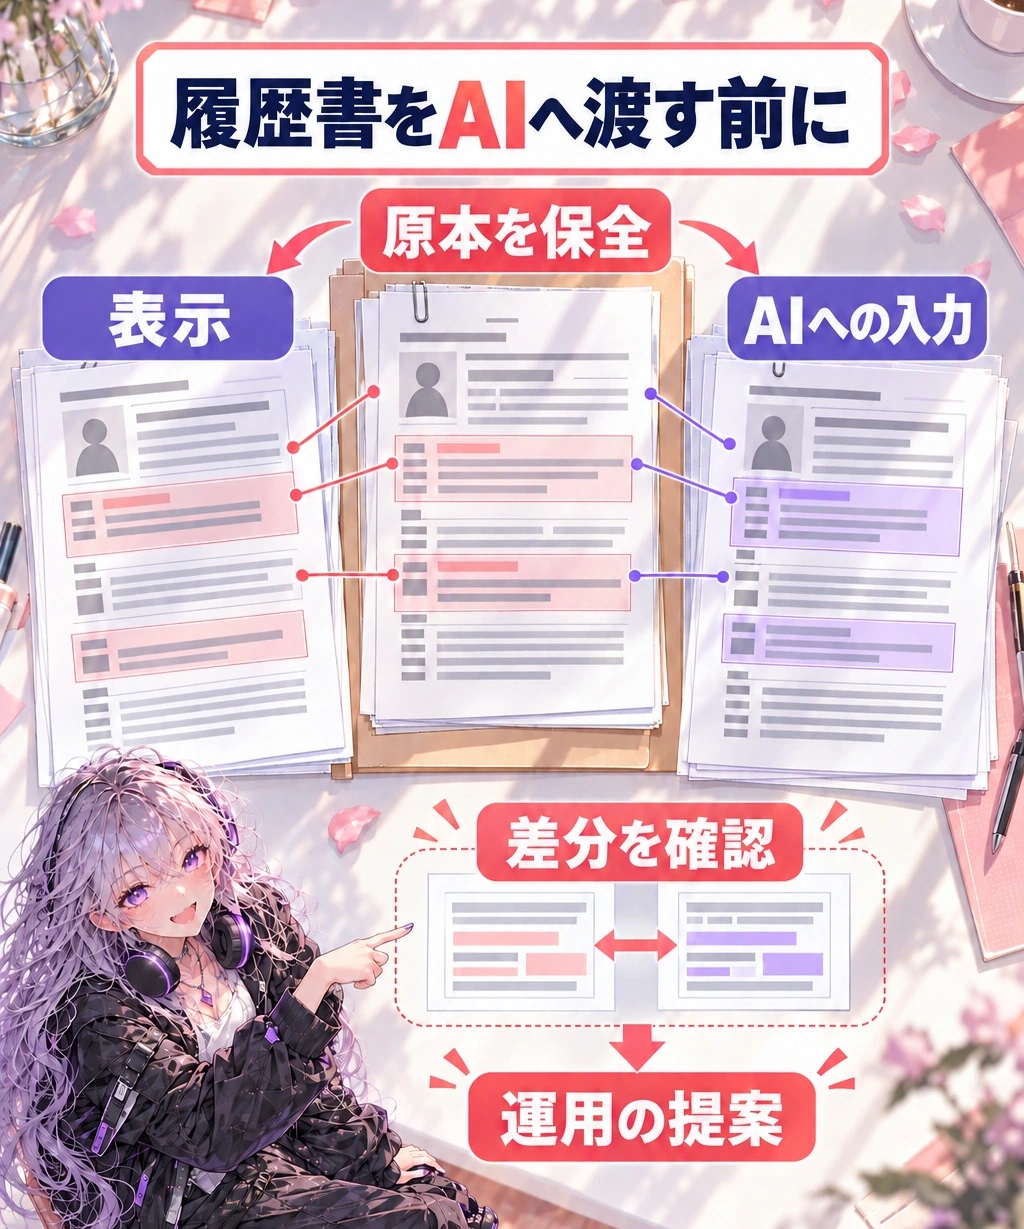
受付時に残すものは、受領した原本、人が読めるページ表示、AIへ実際に渡す抽出内容の三つです。比較用のコピーを作っても、受領原本は書き換えず、版や受付日時と対応付けます。これは研究の差分確認を、受付業務へ応用した運用案です。
順番の要点は、要約を作ってから怪しい箇所を探すのではなく、評価へ入る前の入力を確かめること。AIの回答だけを読み直しても、何が混ざったのか追えない場合があります。
抽出結果では、ページ上の経歴・資格・技能と対応しない記述、読めない文字、見出しと本文の混線を確認します。差があれば、該当ページと抜粋を人へ戻します。抽出できない書類や画像化されたPDFも「異常なし」にはせず、別の読取手段または通常の人手確認へ回します。
ただし、画像化やOCRへ切り替えるだけで安全になるとは限りません。OCRには読み間違いがあり、視覚情報の解釈にも限界があります。方式を変えた後も、AIに渡った内容と原本を追えることを確認してください。
履歴書には個人情報が含まれます。確認のために、組織で利用を認めていないオンライン変換サイトや個人のAIアカウントへ原本を送らない運用にしましょう。保存場所・閲覧者・保存期間は自社の方針と必要な確認に従います。本記事は一律の法定保存期間を示すものではありません。
差分がなくても、書類の中の文言をAIの評価ルールへ昇格させない境界は必要です。次は「何を読むか」から「どう扱わせるか」へ進みます。
履歴書を採用基準の命令にしない
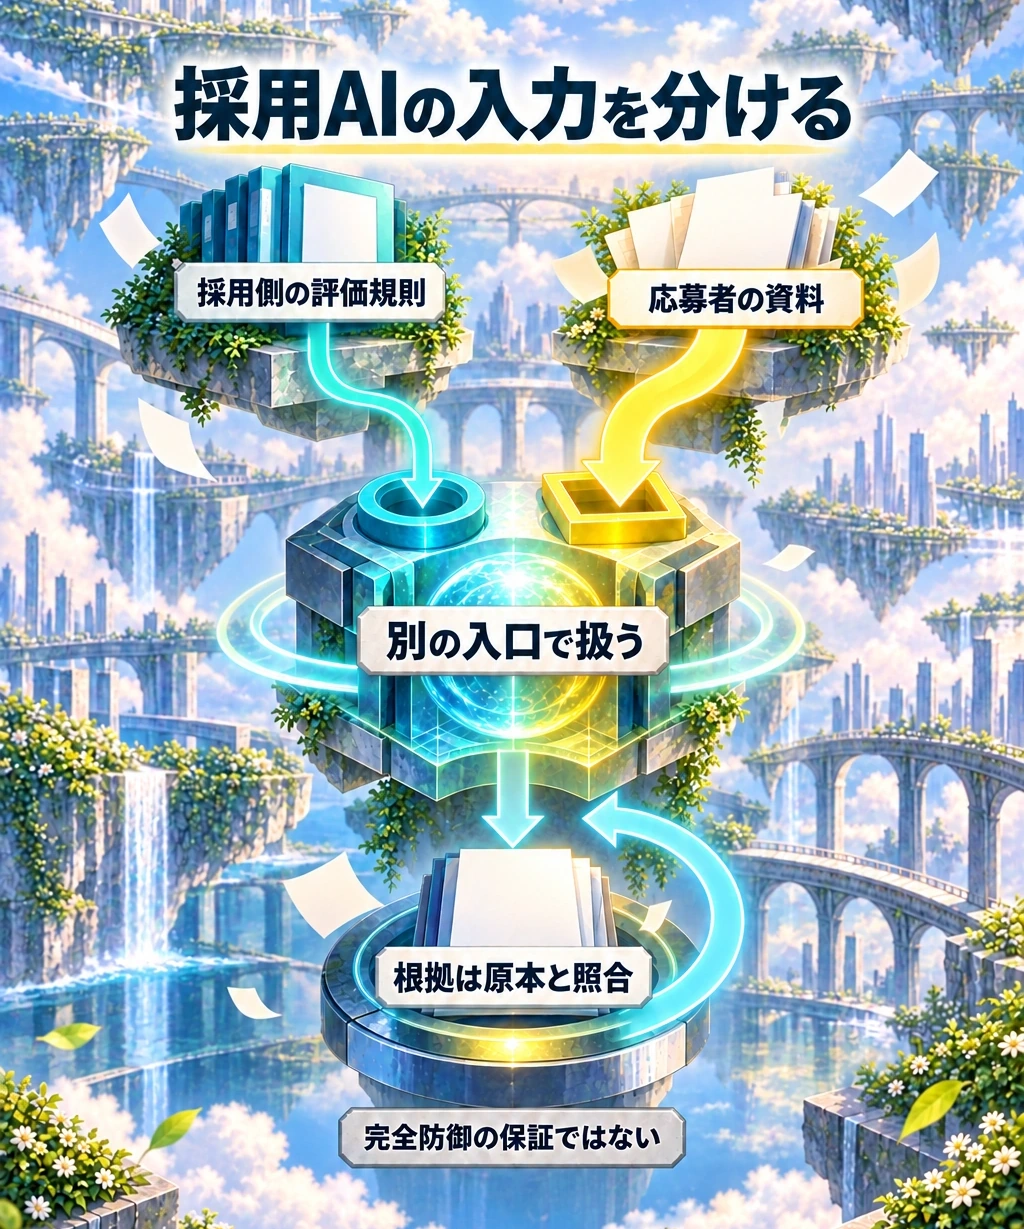
採用基準や評価手順は採用側が用意するルールです。応募者の文書は、その基準に照らして読む資料です。この役割を分け、書類中の文言に評価手順を変更させない設計が基本になります。
NISTの解説は、信頼された内部指示と外部データの分離不足を、AIエージェントへの間接的な操作の原因として説明しています。OWASPの対策も外部コンテンツの分離、最小権限、人の関与を挙げています。
自作の連携なら、採用側の指示と応募者データの入力経路を分け、AIに与える操作権限を必要な範囲に絞ります。市販ツールなら、画面に注意書きを足すだけで済ませず、入力の扱いをベンダーへ確認します。「履歴書の指示には従わない」と一文を足したことだけで、防御完了とは判断できません。
防御研究のResumeShieldは、104件の合成文書による評価で、守りを組み込んだ処理では操作成功がなかったと報告しました。入力チャネルの分離を含む結果です。ただし、限定したベンチマークの結果であり、あらゆる製品・書類・言語で完全に防げる証明ではありません。論文の対象と結果を製品の保証へ読み替えないことが大切です。
AIに評価を返させる場合も、順位だけでなく、判断の根拠となる原文箇所と不足情報を併記させます。その出典表示自体も原本と照合します。もっともらしい引用が付いているだけで、正しい根拠とは限りません。
技術的な境界があっても、検出器が誤る可能性は残ります。最後の分岐は、書類にフラグが立ったときに何をするかです。
不審な差分は不採用ではなく再確認へ
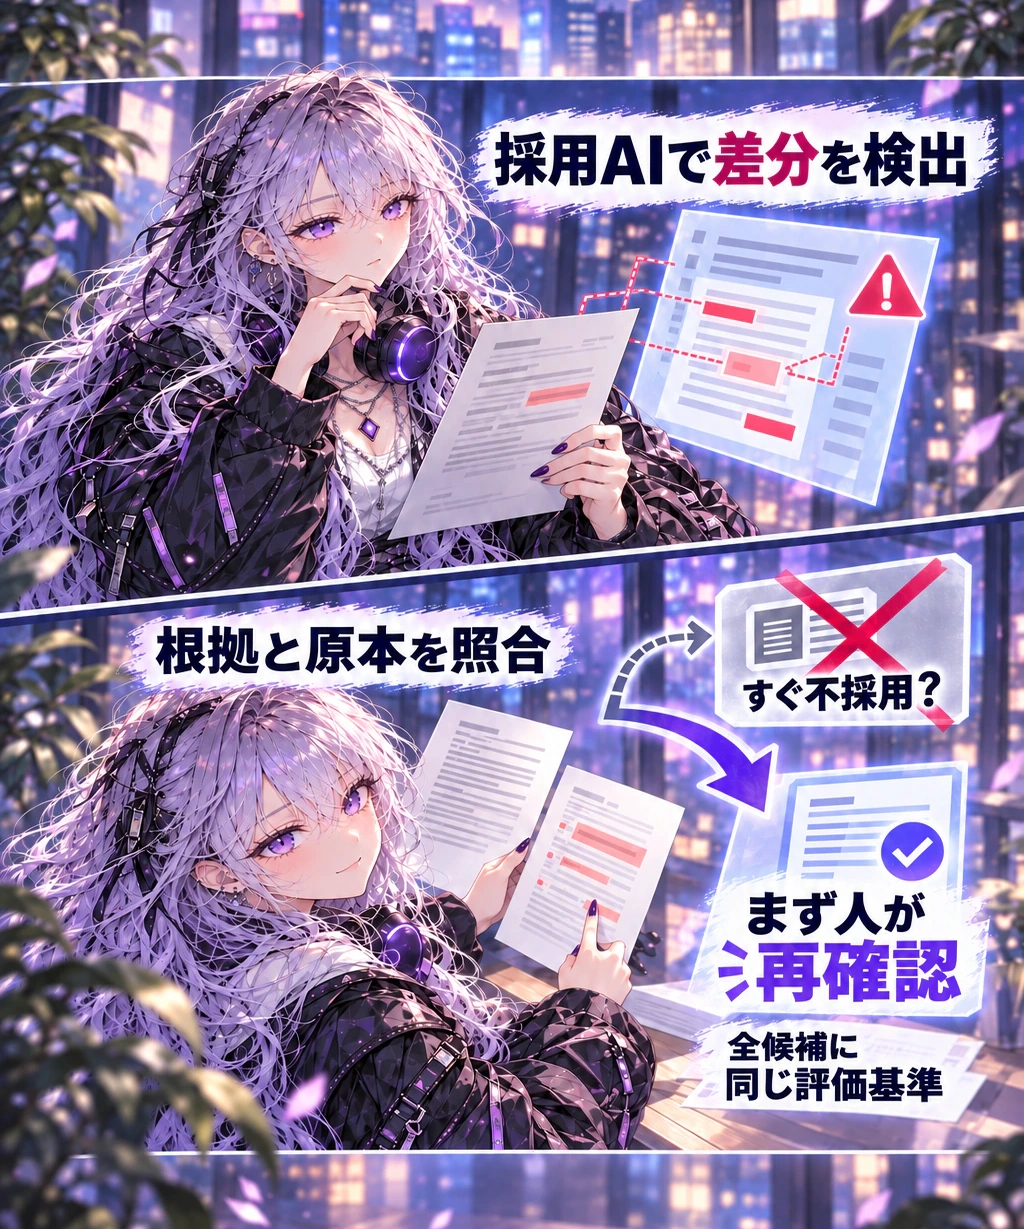
隠れた文字が見つかったとしても、意図的な操作か、文書生成や変換で生じたものかは確認が必要です。検出器のフラグを、そのまま候補者の誠実さや適性の判定へ変換しないでください。
再確認では、どのページの何が表示と異なるのかを記録し、AIがその記述を評価の根拠に使ったかを追います。必要に応じて候補者へ内容確認や読み取りやすい版の提出を依頼し、元の書類も保全します。フラグだけを理由に自動で不採用通知を送る運用は避けましょう。
フラグが付かなかった書類も、通常の採用基準と人の確認から外す理由にはなりません。英国ICOの採用自動化に関する報告は、人の関与を設けるなら、同じ選考段階の全候補者に一貫して適用することを示しています。これは英国の制度を背景にした資料で、日本のすべての採用へ同一の法的義務が適用されると述べるものではありません。
人がいるだけでも十分とは限りません。担当者が原文とAIの理由を読める、誤った根拠を外せる、判断を変更できる、変更理由を残せる状態が必要です。「AIがそう言ったので承認」を繰り返すだけでは、再確認の意味が薄れます。
検出は確認の優先度を付ける材料、採用判断は同じ基準で行う別の仕事と分けます。ここまでを実装できるかは、導入するツールの仕様にも左右されます。
導入前にベンダーへ確認したい5つのこと
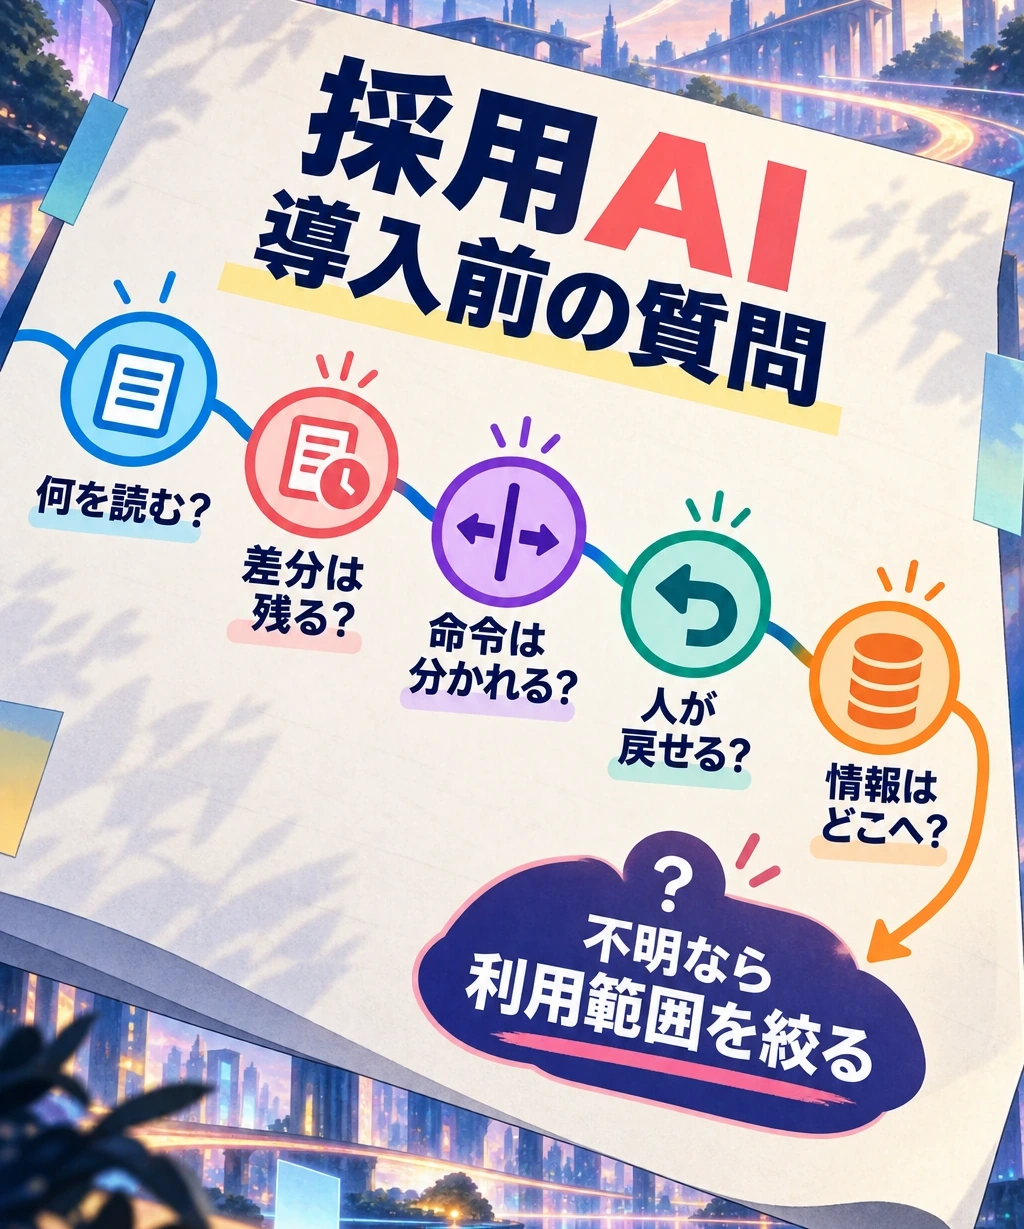
製品の「AI対応」「不正検知あり」という説明だけでは、今回の境界を判断できません。次の質問を、営業資料の一般論ではなく、利用するプラン・機能について確認してください。以下は本記事の運用提案で、特定製品の実装済み機能の一覧ではありません。
| 聞くこと | 確認したい内容 |
|---|---|
| 何をAIへ渡す? | ページ画像、抽出テキスト、OCRのどれか。読取失敗時の扱いも確認。 |
| 差分は残る? | 原本・表示・実際の入力と、フラグの根拠を担当者が照合できるか。 |
| 命令は分かれる? | 応募書類と採用側の評価規則をどう分離し、どの条件で検証したか。 |
| 人が戻せる? | AIの理由を見て再評価できるか。自動排除や通知の停止方法はあるか。 |
| 情報はどこへ行く? | 保存先、閲覧権限、学習利用、委託先、削除の取扱いを契約で確認できるか。 |
回答が曖昧なら、まずAIの用途を文書整理や下書きなど、担当者が原文を確認できる範囲に絞る選択があります。比較評価や順位付けを始める前に、架空の候補者情報など個人情報を含まない、利用を認められた確認用文書で、入力と根拠を追えるか確かめます。テストに通ったことも、未知の操作をすべて防ぐ保証にはしません。
【Noa's View】
この問題で先に買いたいのは「検出精度の数字」ではなく、判断をやり直せる余地です。AIの読み取りが間違っても、原本と理由が残り、人が戻せるなら修正できます。回線を増やしたりVPNを追加したりしても、履歴書と評価命令の混同は解決しません。まず受付から再確認までの責任者と戻し方を決め、その後で必要なツールを選ぶのが妥当だと考えます。
書類の共有権限や、外部AIへ情報を入れるルールも整理したい少人数の職場には、5人会社のデジタル防衛チェックがあります。端末・アカウント・生成AI利用などの初期確認用で、履歴書の隠し文字を検出したり、採用AIの安全性を認証したりする機能ではありません。
今日決める一歩はシンプルです。AIへ渡った内容を見られるか、理由を原本へ戻せるか、差があったとき誰が再確認するか。この三つを説明できる状態から、採用AIの利用範囲を広げていきましょう。
主な一次資料(2026年10月15日確認)