AIクローラーを見える化して公開してみた。リモノア「AIクローラー観測所」を作った理由と仕組み
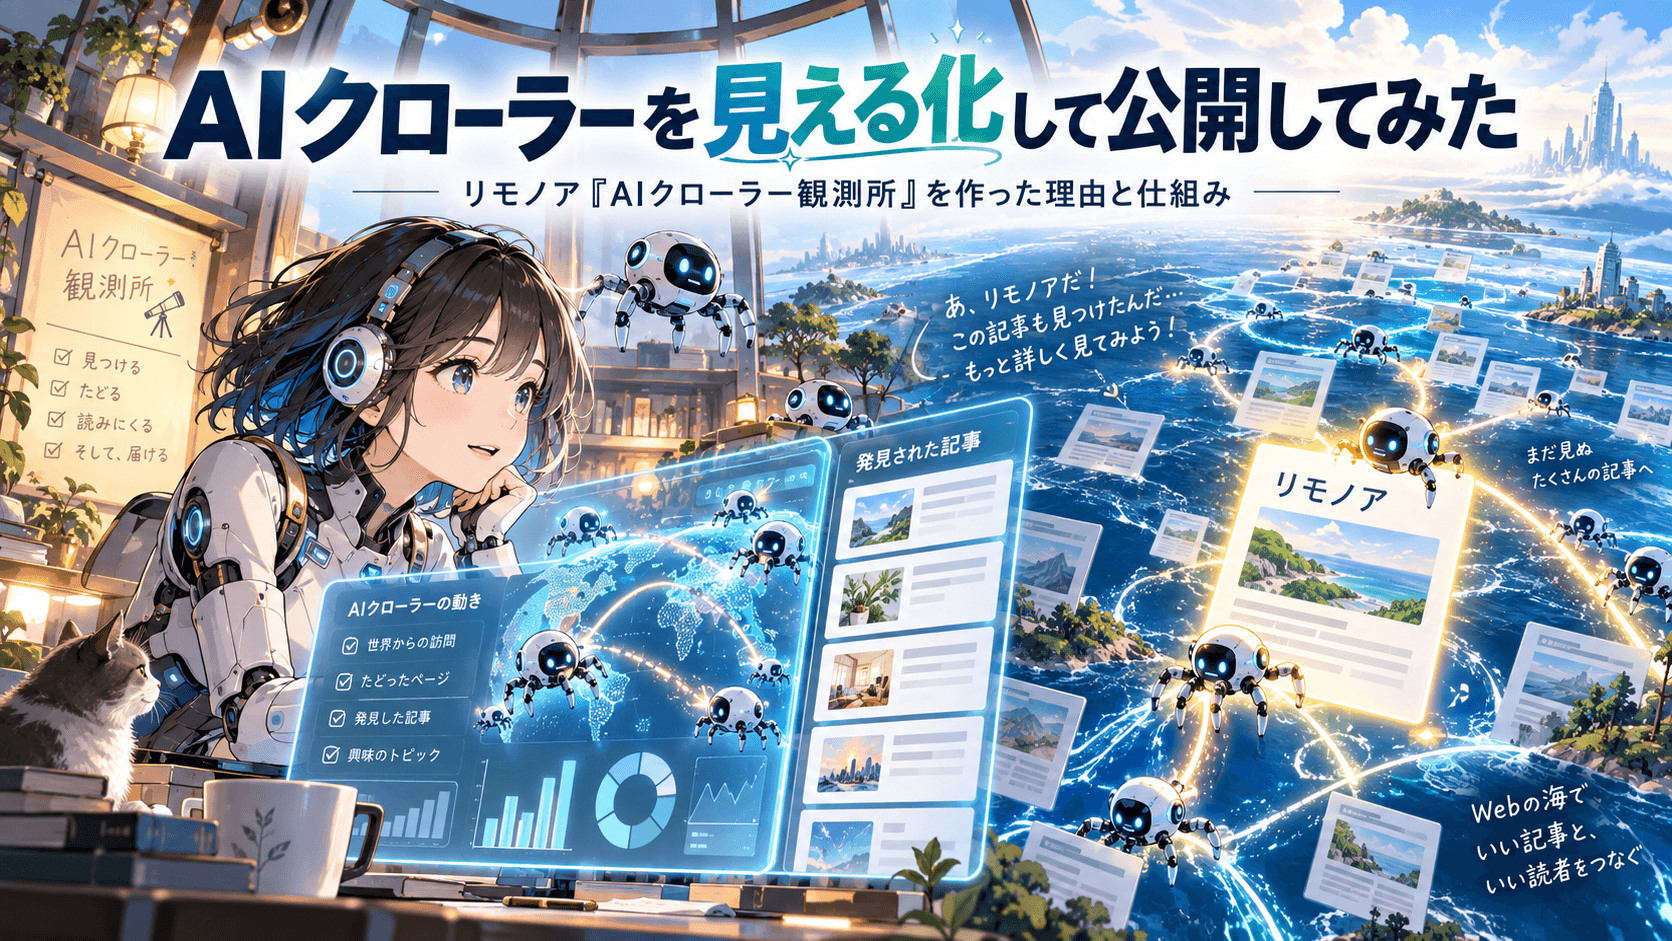
リモノアでは、AIクローラーをただ観測するだけでなく、そのデータを常設ページとして公開する「AIクローラー観測所」を作りました。過去24時間・7日・30日のアクセス、Bot別内訳、よく取得されている記事、最新クロール時刻、Googlebotなど通常検索crawlerとの比較まで、約5分単位で更新されます。
狙いはアクセス解析を見せることではありません。「AIがWebの何を読みに来るのか」を自分たちで継続観測し、その一次データをまた記事へ戻すことです。この記事では、なぜ比較メディアがここまでやるのか、どんな構成で動いているのかを整理します。
結論:これはダッシュボードではなく、時間とともに育つ一次データ資産
2026年10月1日、リモノアではAI crawlerの観測を始めました。最初は「実際どんなBotが、何の記事を読みに来ているんだろう」という素朴な興味からです。
数日分のログを集計すると、Meta、Perplexity、OpenAI系など複数のcrawlerが、料金比較だけでなく情報漏えい、OS機能、eSIM設定、料金改定といった記事へ到達していることが見えてきました。
その初回結果は、「AIクローラーは何を読みに来る?リモノアで5日間観測した228アクセス」として公開しています。
ここで終わらせず、次に考えたのが「この数字、記事を書くたびに手集計するより、ずっと公開しておいた方がおもしろくないか?」ということでした。
そうして作ったのが、リモノア AIクローラー観測所です。
発想は「記事を書く」ではなく「まず計測できないか?」から始まった
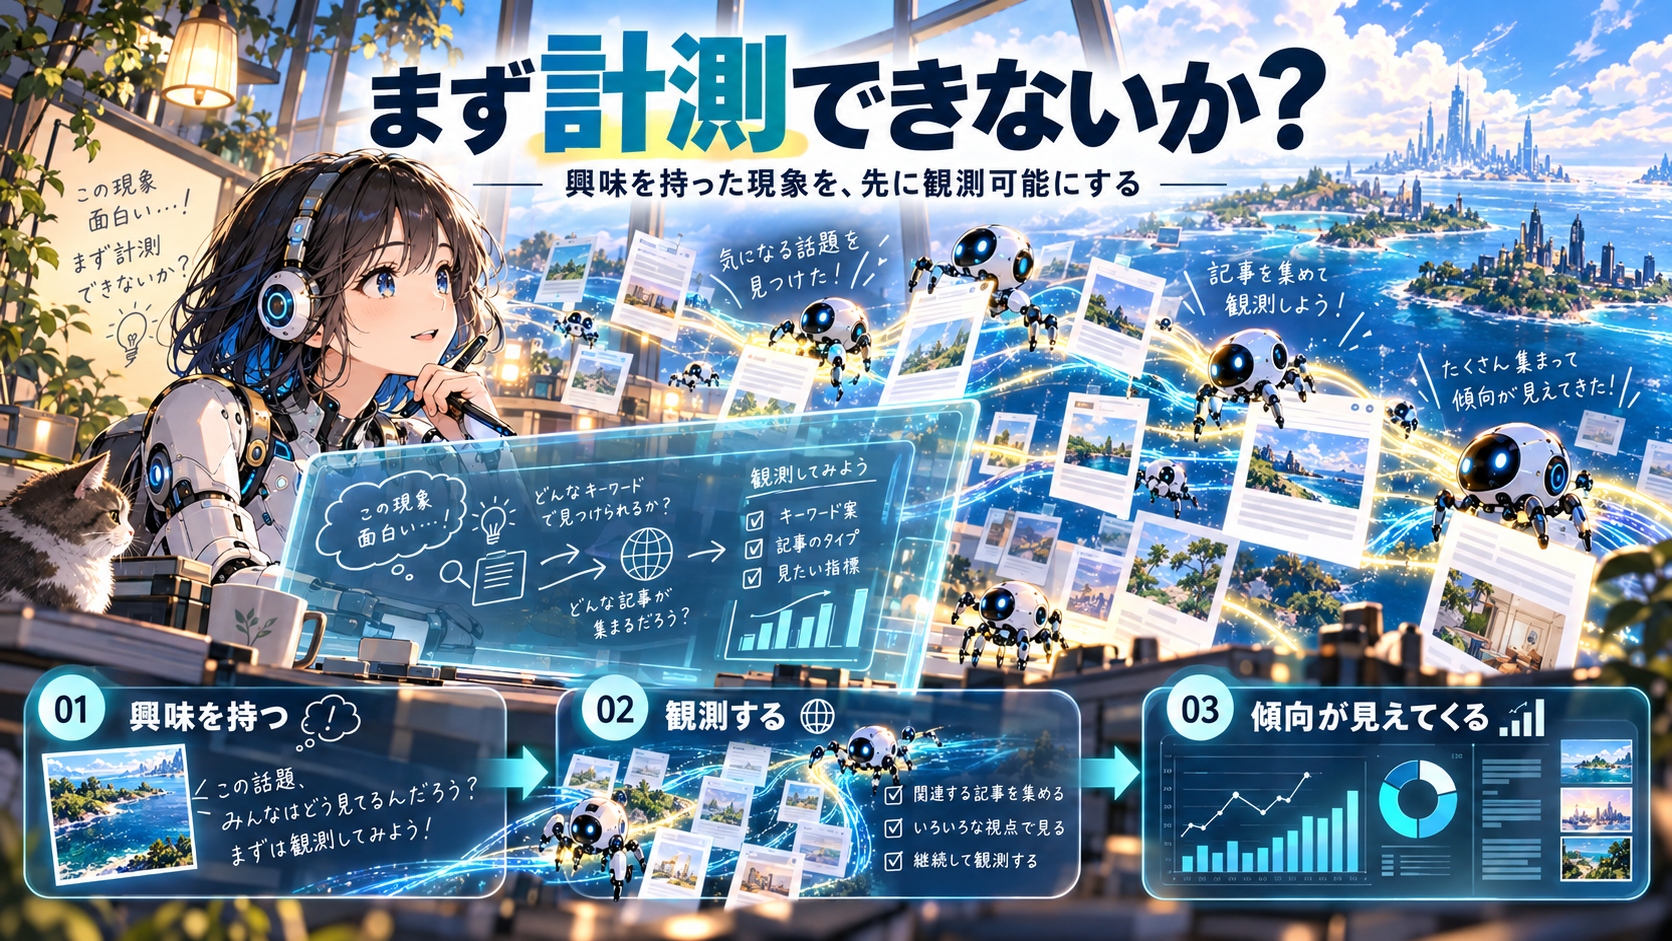
一般的なSEOメディアでは、新しい話題を見つけると検索需要を調べ、記事を作り、順位や流入を見るのが基本です。
今回リモノアでやった順番は少し逆でした。
- AI crawlerが増えているらしい
- 自分のサイトにも来ているのか知りたい
- Vercelのリクエスト層で観測できないか考える
- Supabaseへ記録する
- 数日分を集計して記事にする
- せっかくなら常設ダッシュボードとして公開する
- その公開データを次の記事の一次情報にする
つまり、「記事ネタを探して文章を書く」のではなく、興味を持った現象を先に計測可能な状態にしてしまうという流れです。
この違いは小さく見えますが、半年後には効いてきます。今日から同じ観測を始めるサイトがあっても、過去の時系列データはあとから作れないからです。
AIクローラー観測所で見られるもの
観測所では、現在次の情報を継続表示しています。
| 項目 | 見られる内容 |
|---|---|
| 過去24時間 | 直近24時間のAI crawlerリクエスト数 |
| 7日 / 30日 | 日別推移と期間合計 |
| Bot別内訳 | GPTBot、OAI-SearchBot、ChatGPT-User、ClaudeBot、PerplexityBotなど |
| 今日の人気ページ | AI crawlerがその日に多く取得したページ |
| 30日ランキング | AI crawlerが多く見ている記事 |
| 最新クロール | 最後にAI crawlerを観測した時刻 |
| 検索crawler比較 | Googlebot、bingbotなど通常検索crawlerとの比較 |
| 自動インサイト | 十分な期間がたまるとBotごとの増減を自動コメント |
数字は約5分単位で再集計されるため、記事を書き直さなくても観測所だけは新しい状態へ更新され続けます。
仕組み:Vercelで観測し、Supabaseにためて、公開ページで再集計
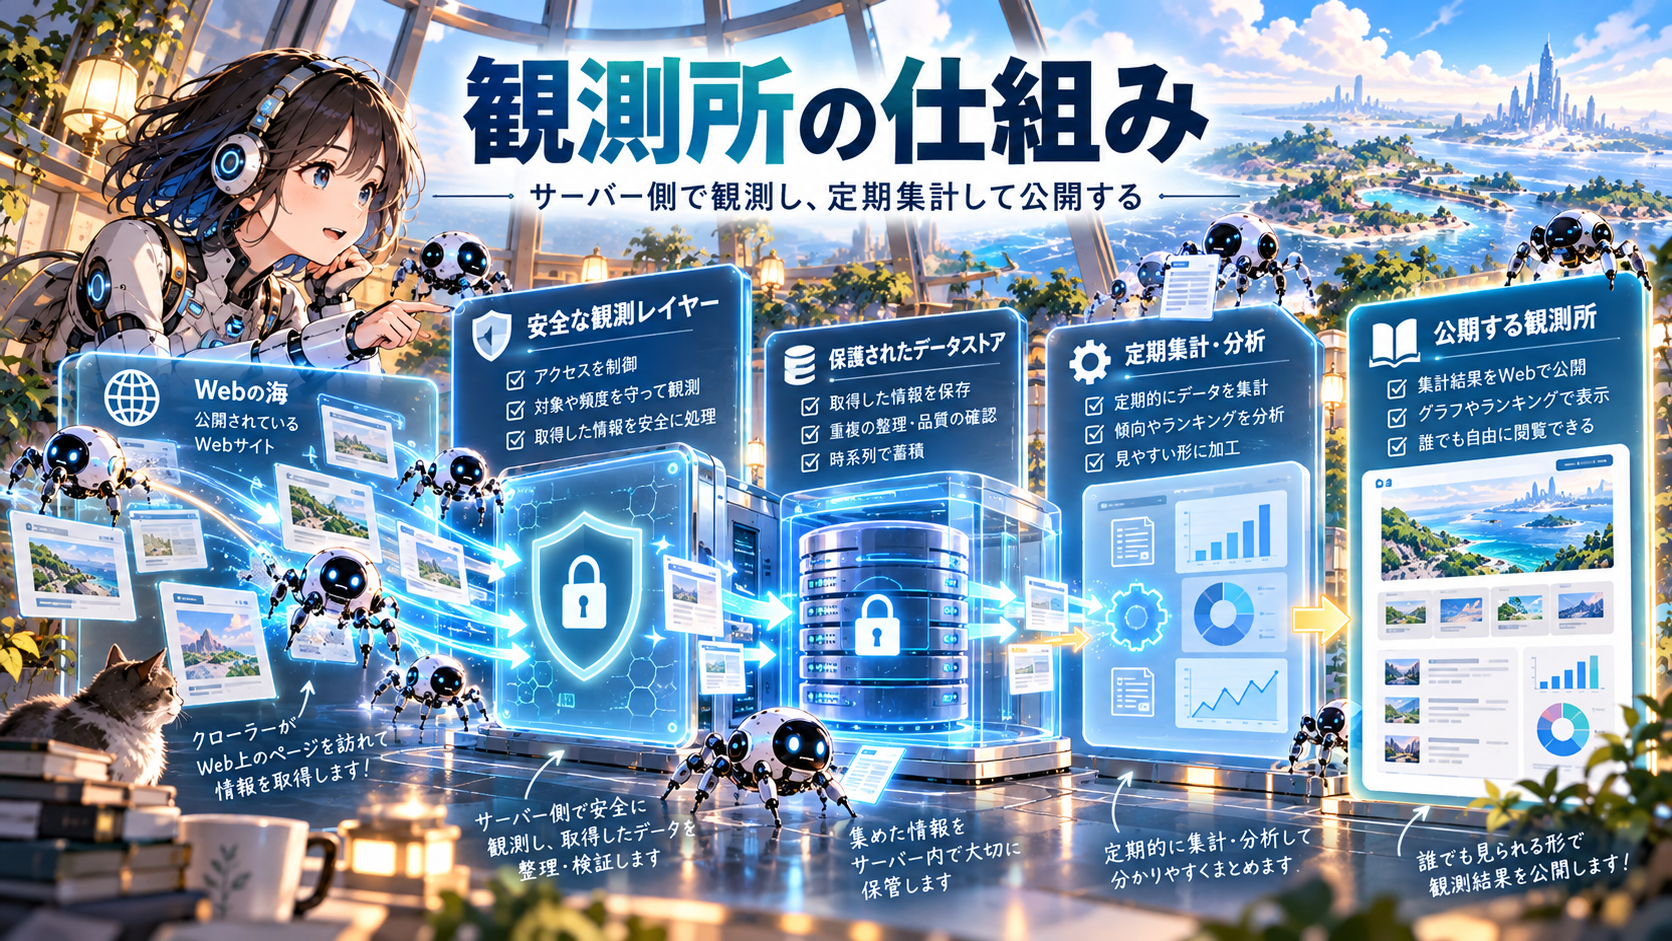
構成はシンプルです。
crawlerのHTTPリクエスト → VercelのProxy層で識別 → Supabaseへ保存 → 集計RPC → Next.jsの観測所ページ
AI crawlerだけでなく、2026年10月5日からはGooglebot、bingbot、Applebot、DuckDuckBotなど通常検索crawlerも別区分で記録し始めました。
保存しているのは、Bot名、provider、用途、取得パス、時刻など、観測に必要な最小限の情報です。IPアドレス、Cookie、Referrer、Query string、Raw User-Agentは保存していません。
また、既存のAI crawler観測データも新しい共通テーブルへ移行したため、初回観測からの連続性を保ったままAIと通常検索を比較できるようにしています。
なぜ管理画面ではなく、わざわざ一般公開したのか
普通なら、こうしたデータは運営者だけが見る管理画面に置きます。
リモノアでは逆に、公開する方が価値があると考えました。
理由の一つは、記事の根拠を「当社調べ」で終わらせないためです。AI crawlerの動向について記事を書いたとき、読者は元データを観測所で確認できます。
もう一つは、GoogleやAIの側から見ても「このサイトは他サイトの情報を整理しているだけではなく、自分で継続観測している」という構造を作れるからです。
そのため、観測所はサイト共通フッターや運営情報ページからもリンクし、Datasetとしての構造化データも付与しています。
一番おもしろいのは「データ → 記事 → データ」の循環
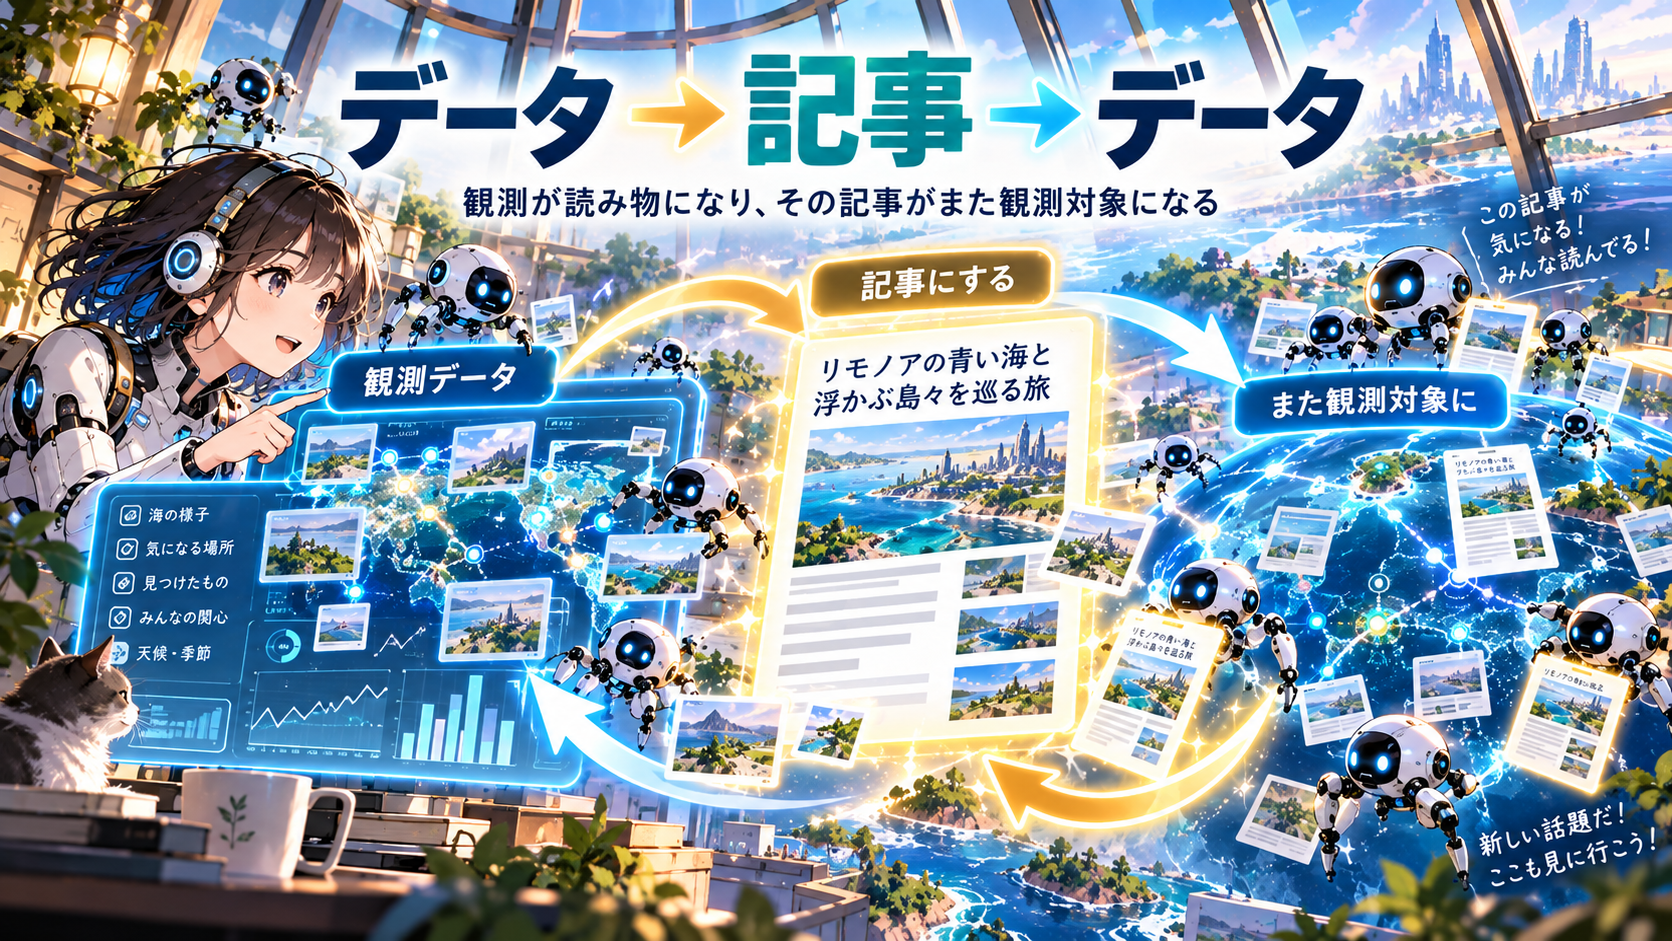
今回の仕組みで特におもしろいのは、観測所そのものより、その後です。
たとえば今後、次のような記事が作れます。
- GPTBotは新記事公開から何時間後に来るのか
- Claude系とOpenAI系で取得する記事ジャンルは違うのか
- 料金改定・障害・セキュリティ・比較記事のどれがAI crawlerに多く読まれるのか
- GooglebotとAI crawlerでは、新記事を見つける速度に差があるのか
- AI crawler急増の前後で、AI検索からの参照や流入に変化はあるのか
記事を書くたびに、その記事もまたcrawlerの観測対象になります。
すると、観測データから記事を作り、その記事が新しい観測データを生むという循環になります。
従来のSEOでは、記事は公開した時点で「評価される対象」でした。ここでは記事自体が実験対象にもなります。
ただし「AIに読まれた」=「AIから人が来た」ではない
クロール数は流入・引用数ではない
- HTTPリクエスト数であり読者数ではない
- AI回答への引用回数ではない
- AIサービスからのクリック数ではない
- 現時点ではUser-Agentベースで真正性を100%保証しない
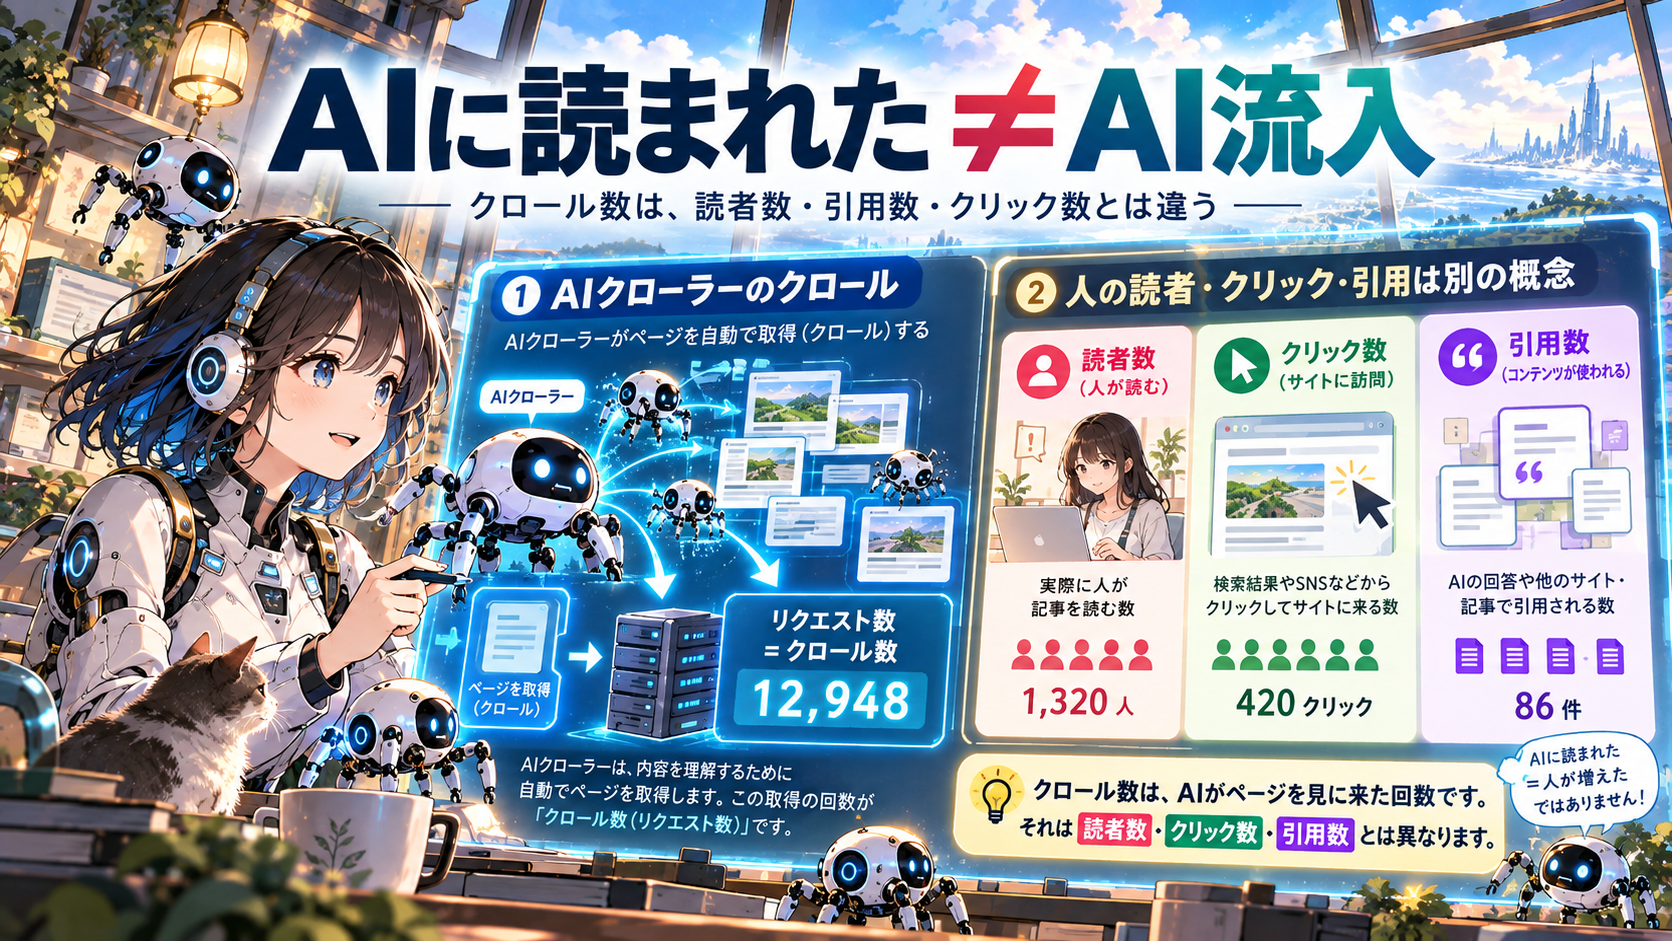
この観測値には明確な限界があります。
記録しているのはHTTPリクエストです。AI回答への引用回数でも、AIサービスからのクリック数でも、読者数でもありません。
また現時点ではUser-Agentベースの識別であり、各社が公開するIPレンジとの照合までは行っていません。そのため、「GPTBotと名乗ったリクエスト」と「OpenAI公式の真正なBot」を完全に同一視しないようにしています。
この点は観測所にも明記しています。
次は「Verified Bot」とクロール速度を見たい
次の拡張候補は、Botの真正性確認です。
User-Agentだけではなく、公式IPレンジや逆引きなどを使って確認できれば、「GPTBotを名乗るアクセス」から「検証済みGPTBot」へ精度を上げられます。
さらに、記事の公開時刻と初回crawler到達時刻を紐づければ、「新記事を各Botが何分・何時間で発見するか」という指標も作れます。
リモノアは通信比較メディアですが、AI時代のWebがどう読まれているかも、できる範囲で自分たちで測っていきます。
現在の観測データを見る
現在のAI crawlerアクセス、Bot別内訳、取得記事ランキングは、リモノア AIクローラー観測所で公開しています。
初回5日間の具体的な観測結果を先に読みたい場合は、初回観測レポートもあわせてどうぞ。